API d'IA et GPU cloud en Algérie (2026) : architecture, vrai coût des tokens en dinars et points à vérifier
Le guide 2026 des API d'IA et du GPU cloud en Algérie : ce qu'est DEVUP AI, comment fonctionne une passerelle prête pour la production, le vrai coût d'un token en dinars et une checklist en 12 points.
Sur cette page
Choisir un fournisseur d'IA en Algérie se résumait autrefois à une question : est-ce que je peux payer ? Cette question a désormais une réponse. La plus difficile est ailleurs : distinguer une plateforme prête pour la production d'une simple page marketing, avant d'y construire votre produit.
Ce guide y répond avec de l'ingénierie, pas avec des adjectifs. Il explique comment une API d'IA et un cloud GPU doivent être construits, ce que coûte vraiment un token en dinars, et comment démasquer un fournisseur trompeur depuis votre propre terminal, en cinq minutes. Chaque affirmation sur DEVUP AI renvoie à une page publique que vous pouvez ouvrir et vérifier. Vérifiez, ne croyez pas sur parole.
Qu'est-ce que DEVUP AI ?
DEVUP AI est une plateforme d'infrastructure d'IA basée à Alger, en Algérie. Elle offre aux développeurs et aux entreprises une seule API pour plus de 200 modèles d'IA, des serveurs GPU et CPU à la demande, et des outils de développement comme l'extension d'éditeur DEVUP Code. Tout est facturé en dinars algériens depuis un solde prépayé.
| DEVUP AI en un coup d'œil | |
|---|---|
| Ce que c'est | API d'inférence d'IA, cloud GPU et CPU, et outils de développement |
| Basée à | Alger, Algérie. Le support, les revues de sécurité et les litiges de facturation sont traités directement par DEVUP AI en Algérie |
| Paiement | Dinars algériens, rechargés avec BaridiMob, CIB ou Edahabia. Aucune carte étrangère |
| Modèle tarifaire | Paiement à l'usage, sans abonnement mensuel, crédit de départ gratuit pour les nouveaux comptes |
| API | https://api.devupai.com/v1, compatible avec le format OpenAI, plus l'API Anthropic Messages et une API native |
| Modèles | Plus de 200 : texte, raisonnement, image, vidéo, voix, embeddings, reranking |
| Compute | Plus de 30 modèles de GPU et des instances CPU, facturés à la seconde |
| Outils de développement | DEVUP Code pour VS Code, Cursor et Antigravity ; le SDK Node.js officiel devupai ; un Playground |
| Données | Les prompts et réponses de chat ne sont pas stockés ; aucun entraînement sur les données des clients |
| Registres publics | Documentation, page de statut, changelog, limites de débit |
Le résumé en 60 secondes
Commencez sans engagement. Chaque nouveau compte reçoit un crédit de départ gratuit, sans dépôt. Aucun abonnement mensuel : vous payez à la requête depuis votre solde en dinars.
Une API, toutes les modalités. Texte, raisonnement, images, vidéo jusqu'à la 4K avec le son, transcription, synthèse vocale, embeddings et rerankers, chacun listé avec son prix sur la page des tarifs.
API et GPU sont facturés séparément. Les appels API sont facturés selon ce que vous demandez. Les serveurs GPU et CPU de DEVUP AI Compute sont facturés à la seconde. Utiliser l'API ne vous coûte jamais rien pour le cloud GPU.
Des outils de développement natifs. L'extension gratuite DEVUP Code, le SDK Node.js officiel, et la compatibilité avec les formats OpenAI et Anthropic, pour que des outils comme Claude Code tournent sur votre solde en dinars.
Auditez-nous comme vous auditeriez n'importe qui. Un script open source vérifie en cinq minutes tout fournisseur compatible OpenAI : le modèle derrière le nom, les tokens comptés face au tokenizer officiel,
usage,max_tokens, le streaming et la fenêtre de contexte.Une fiabilité publique. La page de statut publie 90 jours de disponibilité pour cinq services. Le 15 novembre 2026, elle affichait 100,00 % pour chacun.
Passerelle transparente ou boîte noire ?
Toute plateforme d'IA se place entre vous et les modèles. Ce qui compte, c'est ce qu'elle vous laisse voir et contrôler.
Le risque du routage opaque
Certains produits vendent un accès sous forme de forfait et choisissent le modèle à votre place, en coulisses. Pour une application de chat utilisée par une seule personne, cela peut suffire. Pour un logiciel en production, c'est un risque :
Les sorties structurées cassent. Un schéma JSON qu'un modèle respecte parfaitement peut revenir mal formé avec un autre. Si le modèle change sans prévenir, votre parseur échoue en production.
L'appel d'outils change. Les modèles diffèrent dans leur façon d'appeler des fonctions, dans le nombre d'appels simultanés et dans le moment où ils s'arrêtent. Un agent réglé pour un modèle peut boucler ou sauter des étapes avec un autre.
Le coût devient invérifiable. Si vous ne savez pas quel modèle a répondu, vous ne pouvez pas savoir si le prix payé correspond au travail fourni.
Ce qu'une équipe sérieuse attend
Une équipe de production attend trois choses de la couche d'inférence : nommer le modèle dans chaque requête, voir quel modèle a répondu, et savoir ce que chaque requête a coûté.
C'est ainsi que fonctionne l'API DEVUP AI. Vous envoyez vos requêtes à https://api.devupai.com/v1 avec le modèle choisi, et la réponse indique exactement ce qui a été utilisé. Chaque réponse porte un identifiant de requête pour le support, et la documentation décrit chaque endpoint, paramètre et code d'erreur. Les limites de débit sont publiques elles aussi : requêtes par minute et requêtes simultanées par compte figurent sur la page des limites.
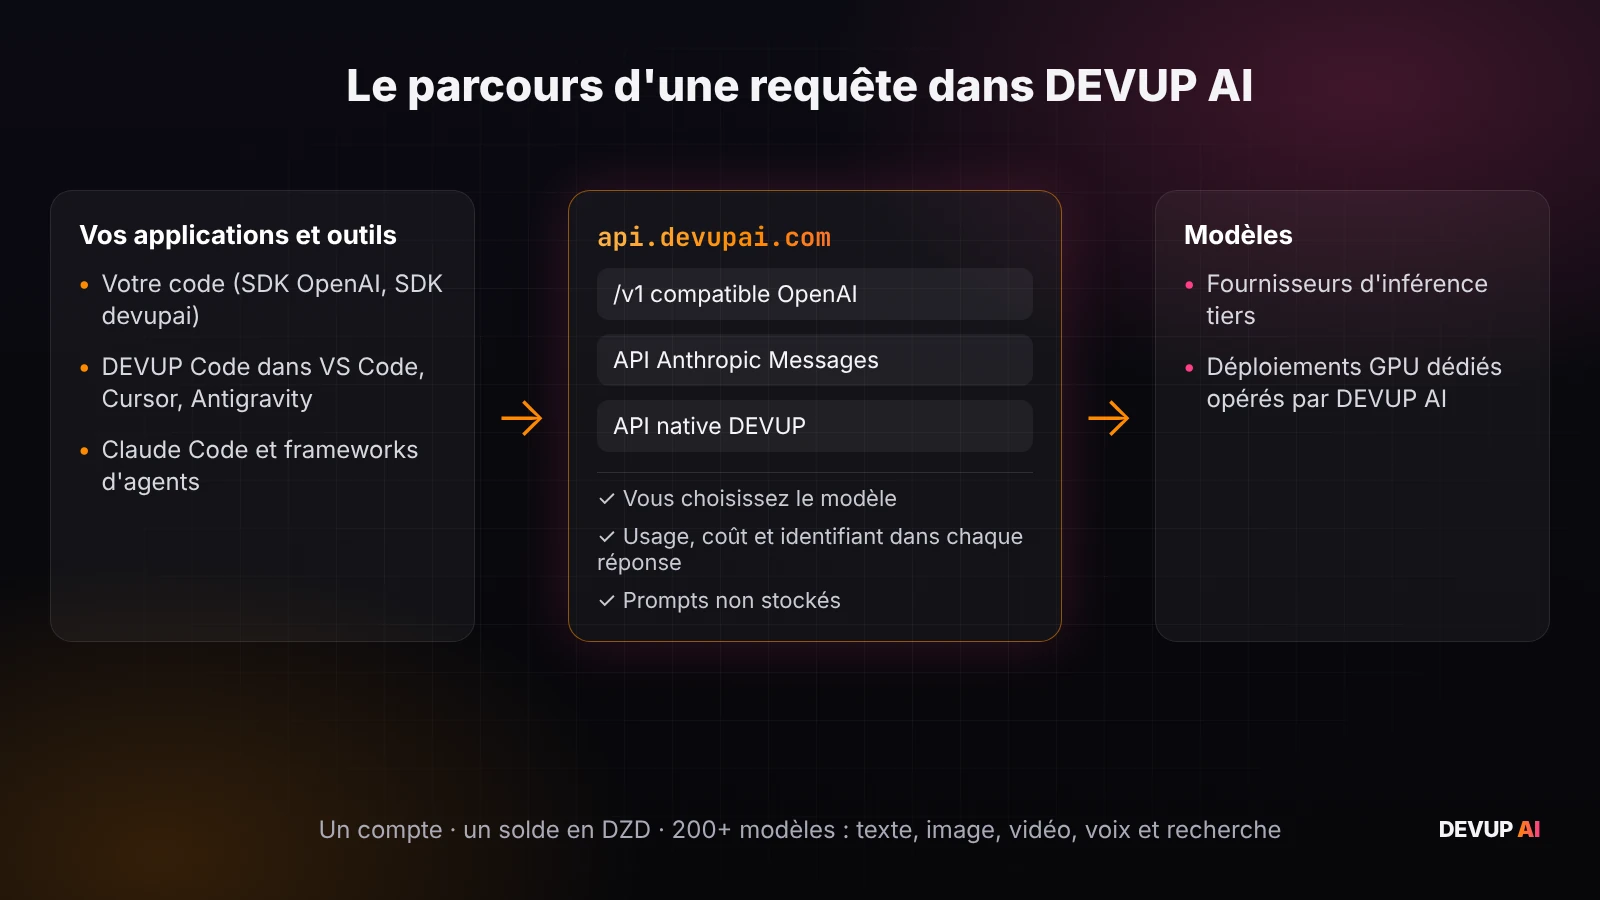
Derrière l'API, DEVUP AI est transparente sur l'endroit où tournent les modèles. La plupart sont servis par des fournisseurs d'inférence tiers. Certains modèles tournent sur des déploiements GPU dédiés que DEVUP AI provisionne et opère sur une infrastructure louée à des fournisseurs cloud, comme l'indiquent les Conditions et la page Sécurité.
L'intelligence qui choisit un modèle pour vous a sa place dans une couche que vous contrôlez : un agent dans votre propre code, ou l'onglet Agent de DEVUP Code, où vous voyez chaque fichier lu et approuvez chaque modification. Des frameworks comme LangGraph, CrewAI ou n8n se connectent à la même API avec un seul réglage, et plus de 35 guides d'intégration montrent comment.
Combien coûte vraiment un token en dinars ?
Comparez le même modèle, ou ne comparez rien
Un prix par million de tokens ne veut rien dire tant que le modèle n'est pas fixé. Les prix varient énormément d'une gamme de modèles à l'autre, même chez un même créateur. Dans le tableau de référence ci-dessous, le prix de sortie le plus élevé vaut 500 fois le moins cher, et cet écart vient des modèles eux-mêmes, pas d'une plateforme.
Quand vous comparez deux offres, vérifiez donc qu'elles citent le même modèle, la même gamme, la même unité. Un modèle de pointe d'un côté et un petit modèle ouvert de l'autre, ce n'est pas une comparaison de prix.
Tableau de référence
Tous les prix et chiffres de ce guide se trouvent dans ce tableau, relevés sur la page des tarifs, la page Compute et la documentation le 15 novembre 2026. La dernière ligne provient de la page des coûts de Claude Code d'Anthropic, consultée le même jour. Les prix et le catalogue évoluent : les pages en ligne font toujours foi.
| Élément | Unité | Entrée | Sortie | Entrée en cache |
|---|---|---|---|---|
| Modèles au catalogue | à cette date | 219 | ||
| Modèles de GPU à louer | à cette date | 32 | ||
| Guides d'intégration dans la documentation | à cette date | 36 | ||
| Crédit de départ des nouveaux comptes | une fois | 50 DZD, valable 7 jours | ||
| Abonnement mensuel | par mois | 0 DZD | ||
Meta-Llama-3.1-8B-Instruct-Turbo | 1M tokens | 7 DZD | 14 DZD | — |
Mistral-Nemo-Instruct-2407 | 1M tokens | 7 DZD | 14 DZD | — |
gemma-4-31B-it-turbo | 1M tokens | 42 DZD | 129,5 DZD | — |
gemma-4-31B-it | 1M tokens | 70 DZD | 140 DZD | — |
DeepSeek-V4.1-Flash-1017 (contexte 1M) | 1M tokens | 70 DZD | 210 DZD | 2,1 DZD |
claude-sonnet-5-5 | 1M tokens | 700 DZD | 3 500 DZD | — |
claude-opus-5-5 | 1M tokens | 1 400 DZD | 7 000 DZD | — |
embeddinggemma-300m | 1M tokens | 0,65 DZD | ||
bge-m3 | 1M tokens | 5 DZD | ||
whisper-large-v3-turbo (transcription) | minute | 0,07 DZD | ||
sdxl-turbo (image) | image | à partir de 0,07 DZD | ||
LTX-2.5-Pro (vidéo avec son) | seconde | 42 DZD (720p) à 136,5 DZD (4K) | ||
| Instance CPU, 2 vCPU / 4 Go | heure, facturée à la seconde | 21 DZD | ||
GPU RTX 2000 Ada 16 Go | heure, facturée à la seconde | 84 DZD | ||
GPU RTX 4090 24 Go | heure, facturée à la seconde | 312 DZD | ||
GPU RTX 5090 32 Go | heure, facturée à la seconde | 487 DZD | ||
GPU H200 SXM 141 Go | heure, facturée à la seconde | 1 852 DZD | ||
GPU B300 288 Go | heure, facturée à la seconde | 3 147 DZD | ||
| Claude Code, coût moyen par développeur dans les déploiements en entreprise (Anthropic) | par jour actif / par mois | environ 13 USD / 150 à 250 USD |
Le cache de prompt : l'économie que la plupart des équipes ratent
Les agents de code et les bots de support renvoient le même long préfixe à chaque requête : le prompt système, les règles, les documents, le contexte du code. Sur les modèles qui le prennent en charge, ce préfixe répété peut être lu depuis le cache à un prix bien plus bas.
Dans le tableau, l'entrée en cache coûte 97 % de moins que l'entrée standard sur DeepSeek-V4.1-Flash-1017. Mesure du 16 novembre 2026 : la même requête de 6 429 tokens envoyée deux fois, avec 6 400 tokens lus depuis le cache au second appel, a vu son coût d'entrée baisser d'environ 96 %.
Prenez un agent de code qui envoie 50 000 tokens de contexte de code suivis d'une question de 2 000 tokens. Si chaque préfixe est lu depuis le cache sur DeepSeek-V4.1-Flash-1017, le coût d'entrée de chaque requête baisse d'environ 93 % : 96 % de ses tokens d'entrée sont lus à 3 % du prix standard.
Deux règles décident de ce que vous économisez vraiment :
Placez le contenu stable en premier. Les instructions et les documents au début, la question de l'utilisateur à la fin. Gardez le préfixe identique octet pour octet : un horodatage en tête casse le cache.
Mesurez, ne supposez pas. Une lecture en cache est probable, pas garantie. Lisez l'usage renvoyé avec chaque réponse pour voir combien de tokens d'entrée ont été lus en cache.
Sur les modèles compatibles, vous pouvez aussi demander explicitement une rétention de 5 minutes ou d'une heure avec prompt_cache_key et prompt_cache_options, comme l'explique la documentation du cache de prompt. Ce cache garde le préfixe exact que vous avez envoyé. C'est différent d'un cache sémantique, qui renvoie une ancienne réponse à une question « similaire » et peut servir des informations périmées.
Pour les chat completions, les niveaux de service ajoutent un levier : Priority pour un traitement plus rapide, ou Flex pour un prix plus bas quand une charge de travail peut attendre.
Est-ce que je paie les GPU si j'utilise seulement l'API ?
Non. L'API et le cloud GPU sont deux produits distincts sur le même compte, facturés séparément.
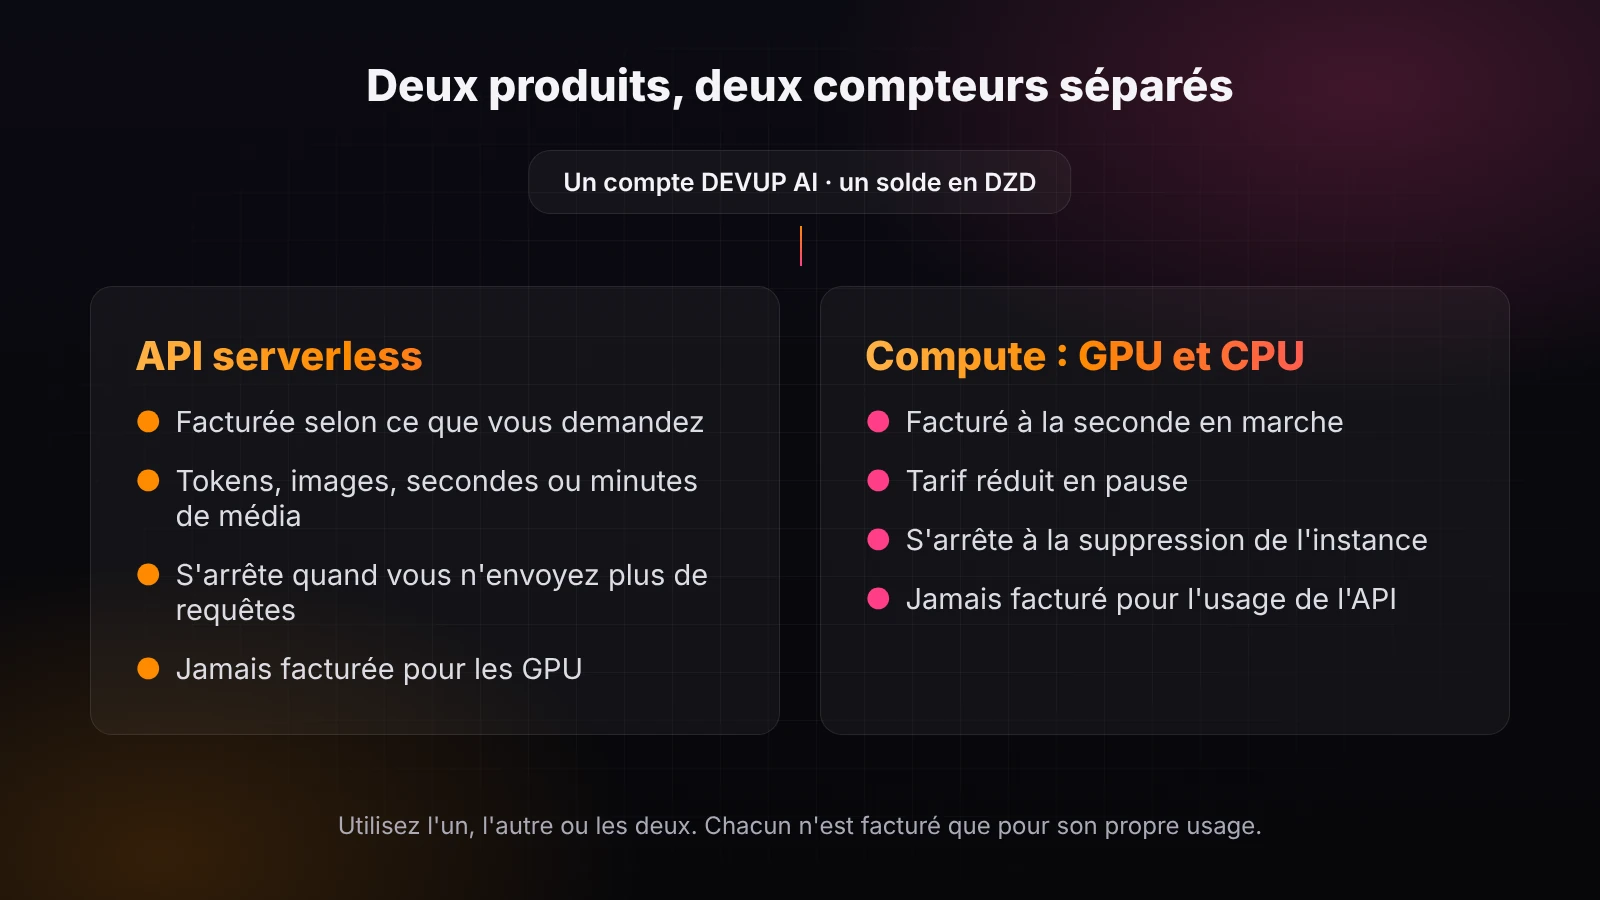
| API serverless | Compute (GPU et CPU) | |
|---|---|---|
| Ce que vous appelez | POST /v1/chat/completions, /v1/embeddings, /v1/images/generations… | Un serveur que vous déployez : SSH, JupyterLab, vos propres conteneurs |
| Ce que vous payez | Les tokens, images, secondes ou minutes de média demandés | Le temps d'existence de l'instance : à la seconde en marche, un tarif réduit en pause |
| Quand la facturation s'arrête | Quand vous n'envoyez plus de requêtes | Quand vous supprimez l'instance |
| Coût pour l'autre produit | Rien | Rien |
Quand le cloud GPU devient utile
Le jour où votre projet a besoin de plus que des appels API, vous ne changez pas de fournisseur et ne cherchez pas de carte étrangère. Depuis le même compte et le même solde en dinars, vous pouvez :
affiner un modèle sur vos propres données, par exemple un entraînement LoRA sur la darija algérienne ;
faire tourner votre propre serveur de modèle ou un traitement par lots ;
garder datasets et checkpoints sur des Network Volumes persistants, qui passent d'une instance GPU à une instance CPU.
Le catalogue Compute propose plus de 30 modèles de GPU, de la RTX 2000 Ada aux H100, H200, B200, B300 et AMD MI300X et MI350X, la plupart disponibles en instances multi-GPU, ainsi que des instances CPU orientées calcul, mémoire ou usage général. Les instances sont provisionnées automatiquement depuis votre tableau de bord, avec vos clés SSH et un modèle JupyterLab officiel. Elles tournent sur une infrastructure cloud tierce, dans plusieurs régions hors d'Algérie, comme l'indique la page Compute.
Au-delà du chat : toute la boîte à outils du développeur
DEVUP Code : un agent IA de code dans votre éditeur
DEVUP Code est l'extension officielle pour VS Code, Cursor et Google Antigravity, publiée sur le Visual Studio Marketplace et sur Open VSX par un éditeur vérifié.
Connexion en un clic. Vous autorisez l'accès sur devupai.com, et aucune clé API n'est copiée dans l'éditeur.
Un onglet Agent à quatre modes : Demander, Planifier, Demander avant de modifier et Modifier automatiquement. Chaque modification proposée s'ouvre en diff, que vous acceptez ou rejetez, et la restauration des fichiers remet les fichiers d'une réponse dans leur état d'origine.
Les fichiers secrets restent à l'écart. Les fichiers
.env, les clés privées, les certificats, les dossiers SSH et Git n'apparaissent jamais dans la recherche et ne peuvent pas être joints.Des règles de projet avec
AGENTS.mdet.devupai/rules.md.Une interface en arabe, de droite à gauche, avec le code et les noms de fichiers gardés de gauche à droite.
Le tour complet est dans notre guide DEVUP Code.
Des API standards : vos outils fonctionnent déjà
Compatible OpenAI : Chat Completions, la Responses API, embeddings, images et audio. Changez l'URL de base et votre code existant fonctionne.
API Anthropic Messages sur
/anthropic/v1/messages, ce qui permet de faire tourner Claude Code sur votre solde en dinars.API native DEVUP pour tout modèle, avec des webhooks signés (HMAC-SHA256) pour les traitements longs.
Le SDK Node.js officiel,
devupai, sur npm. En Python, la bibliothèque officielle d'OpenAI fonctionne en changeantbase_url.Scoped JWT : des jetons de courte durée limités aux modèles que vous choisissez, avec une expiration de 1 heure à 90 jours et un plafond de dépense en dinars. Confiez-en un à un front-end, un prestataire ou une équipe de hackathon sans exposer la clé de votre compte (documentation d'authentification).
Un Playground pour essayer n'importe quel modèle avant d'écrire du code (documentation du Playground).
Toutes les modalités dans un seul compte
| Besoin | Exemples sur DEVUP AI |
|---|---|
| Texte et raisonnement | Claude, GPT, Gemini, DeepSeek, Qwen, Kimi, GLM, Llama, Mistral, Gemma |
| Images et retouche | FLUX-2-max, gpt-image-2.6, sdxl-turbo, Qwen Image, Seedream |
| Vidéo avec son | LTX-2.5-Pro jusqu'à la 4K, veo-3.1, Wan3.0-Video |
| Outils vidéo | video_increase_resolution, jusqu'à la 8K |
| Transcription | whisper-large-v3-turbo, NVIDIA Nemotron ASR |
| Synthèse vocale | Modèles TTS multilingues et de clonage de voix |
| Recherche et RAG | Modèles d'embeddings et rerankers cross-encoder |
Ce que les équipes construisent avec : des API d'IA payées en dinars pour n'importe quelle application, un bot de support client qui répond en darija, et des agents de code dans l'éditeur.
Mes données sont-elles en sécurité ? Ne pas stocker vaut mieux que masquer
Deux approches de la confidentialité existent sur les passerelles d'IA.
Stocker et masquer. La passerelle garde des journaux de requêtes et remplace les données personnelles détectées par des étiquettes comme [NAME] ou [PHONE]. Cela paraît sûr, mais en Algérie cette approche a deux limites techniques :
La détection repose sur des motifs. Les noms, adresses et numéros écrits en darija, en caractères arabes ou en arabizi (
3andi,wach rak) échappent à des règles pensées pour l'anglais.Quand une requête existe justement pour traiter ces données (extraire les champs d'une facture, formater une fiche client, corriger un payload JSON), remplacer les valeurs par des étiquettes corrompt le résultat.
Ne pas stocker. Sur DEVUP AI, les prompts et réponses de chat transitent sans être stockés. DEVUP ne garde que les métadonnées de facturation (modèle, tokens, coût) et n'entraîne jamais de modèle sur vos données, comme l'indique la politique de confidentialité. Les modèles à poids ouverts sont traités sous des conditions qui interdisent l'entraînement sur votre contenu ; pour les modèles propriétaires, la politique de données du créateur du modèle s'applique. Une donnée jamais stockée ne peut pas fuiter d'un journal.
DEVUP AI aligne aussi le traitement des données sur la loi algérienne 18-07 relative à la protection des données personnelles, et reconnaît le contrôle de l'autorité nationale (ANPDP), comme le décrit la page Conformité.
Comment démasquer un fournisseur d'IA trompeur en cinq minutes
Une page de tarifs peut tout affirmer. Une API, elle, cache peu de choses à qui sait quoi mesurer : les modèles qu'elle liste, les tokens qu'elle compte, les limites qu'elle applique. Chaque vérification ci-dessous se lance depuis votre propre terminal, avec votre propre clé, sur n'importe quel fournisseur. Lancez-les aussi sur DEVUP AI. C'est tout l'intérêt.
Sept signaux d'alerte
| Signal d'alerte | Ce qu'il cache souvent | Comment vérifier |
|---|---|---|
| Un prix mensuel fixe pour des modèles de pointe, avec un usage « illimité » ou des limites que personne n'écrit | Des plafonds cachés, un modèle moins cher derrière le nom, ou des comptes partagés (voir le calcul plus bas) | Demandez les limites exactes par écrit, puis lancez l'audit |
| Un modèle propriétaire vendu bien en dessous du prix public de son éditeur, en entrée comme en sortie | La marge doit venir de quelque part : un modèle substitué, des comptes grand public partagés, ou une subvention qui prendra fin | Comparez avec la page de tarifs officielle de l'éditeur, puis lancez le test du tokenizer |
Des réponses sans usage, ou aucun moyen de voir ce que chaque requête a coûté | Vous ne pouvez pas auditer votre propre facture | Vérification 3 de l'audit |
Un modèle annoncé sur le site mais absent de /v1/models, ou des réponses qui citent un autre modèle | Une substitution de modèle | Vérifications 1 et 2 |
| Un accès par identifiant partagé ou par un site de chat au lieu de vos propres clés API | Des abonnements grand public revendus à plusieurs personnes, contre les conditions de l'éditeur du modèle. L'accès peut s'arrêter du jour au lendemain | Exigez des clés API, des clés à portée limitée et des conditions publiées |
| Une immense fenêtre de contexte sur la page, mais des documents longs « oubliés » | Votre prompt est tronqué en silence, ou le modèle n'exploite pas vraiment sa fenêtre | La vérification de contexte, en option, distingue les deux : un prompt tronqué est compté en moins |
| Aucunes conditions d'utilisation, politique de confidentialité, historique de statut ou changelog publiés | Personne n'est responsable quand quelque chose casse | Cherchez ces pages. Celles de DEVUP AI sont liées tout au long de ce guide |
Le calcul derrière les offres « illimitées »
Un fournisseur paie son amont pour chaque token. Un forfait mensuel plafonne ce qu'il encaisse, mais rien ne plafonne le nombre de tokens que vous consommez. Anthropic, qui développe Claude, publie ce que coûte son propre agent de code, Claude Code, par développeur dans les déploiements en entreprise. Les chiffres sont dans le tableau de référence plus haut.
Si un forfait sur les mêmes modèles de pointe coûte une petite fraction de ce montant, la différence est payée de l'une de quatre façons : des plafonds d'usage que vous découvrez plus tard, un modèle moins cher qui répond sous le nom du modèle cher, des comptes grand public partagés entre de nombreux utilisateurs, ou l'argent d'investisseurs jusqu'à épuisement. Aucune ne correspond à ce que l'acheteur croit avoir acheté.
Les comptes grand public partagés méritent un mot. Les abonnements que les éditeurs de modèles vendent aux particuliers sont attribués à une seule personne. Les conditions grand public d'Anthropic le disent clairement : "You may not share your Account login information... with anyone else." Autrement dit : interdiction de partager ses identifiants avec qui que ce soit. Un service bâti sur de tels comptes ne survit que tant que personne ne le remarque.
Le paiement à l'usage n'est pas un choix marketing. C'est le seul modèle où le prix que vous payez suit le coût réel de ce que vous consommez.
Pourquoi le tokenizer ne ment pas
Chaque famille de modèles découpe le texte en tokens avec son propre tokenizer, et les éditeurs les publient : les modèles open-weight fournissent leurs fichiers de tokenizer avec les poids, et OpenAI publie ses encodages dans la bibliothèque tiktoken. Un même paragraphe, surtout en arabe ou en arabe mêlé de français, donne des nombres de tokens très différents d'une famille à l'autre.
Cela donne un test précis. Envoyez deux fois la même requête, la seconde avec un paragraphe de référence en plus. L'augmentation de prompt_tokens annoncée par le fournisseur doit correspondre, à quelques tokens près, à ce que le tokenizer officiel compte pour ce paragraphe. Un fournisseur qui vend « Qwen » mais compte comme une autre famille sert un autre modèle. La même mesure détecte le texte caché ajouté à votre prompt et facturé, ainsi que les tokens de sortie qui ne correspondent pas au texte reçu.
Le test a deux limites qu'il faut énoncer. Il identifie la famille du modèle, pas la précision numérique à laquelle il tourne. Et pour les modèles propriétaires dont le tokenizer n'est pas public, la vérification à faire est la qualité des réponses sur votre propre jeu de tests.
Lancez l'audit vous-même
DEVUP AI publie le script d'audit en open source : ai-api-audit, sous licence MIT, en un seul fichier Python qui n'a besoin que d'une bibliothèque de tokenizer, en option. Il ne contacte que l'URL que vous lui donnez et n'affiche jamais votre clé. Une exécution par défaut envoie cinq petites requêtes, environ 2 000 tokens au total.
| # | Vérification | Ce que signifie un FAIL |
|---|---|---|
| 1 | Le modèle est listé par /v1/models | Vous payez un nom que l'API ne sert pas |
| 2 | La réponse cite le modèle demandé | Un autre modèle a répondu |
| 3 | Chaque réponse renvoie usage, et les chiffres s'additionnent | Votre facture n'est pas auditable |
| 4 | Les tokens du prompt correspondent au tokenizer officiel | Une autre famille de modèles se cache derrière le nom, ou votre prompt a été réécrit |
| 5 | Aucun texte caché important n'est ajouté à votre prompt | Vous payez des tokens que vous n'avez jamais envoyés (signalé comme avertissement) |
| 6 | Les tokens de sortie correspondent au texte reçu | La sortie est surfacturée |
| 7 | max_tokens est respecté | Les limites de dépense de votre code ne tiennent pas |
| 8 | Le streaming fonctionne et renvoie l'usage | Les applications en streaming ne peuvent pas suivre leur coût |
| 9 | La fenêtre de contexte annoncée est réellement servie (en option) | Les documents longs sont coupés en silence. Un WARN signifie que le prompt entier est arrivé et a été compté, mais que le modèle ne l'a pas retenu |
pip install tokenizers
export AI_API_KEY="votre-cle-api"
python ai_api_audit.py --base-url https://api.devupai.com/v1 \
  --model Qwen/Qwen2.5-72B-Instruct --hf-tokenizer Qwen/Qwen2.5-72B-Instruct
Pour auditer un autre fournisseur, changez --base-url et --model. Pour les modèles OpenAI, installez tiktoken et passez --tiktoken o200k_base. Ajouter --context-test 100000 --yes lance la vérification sur document long, qui envoie beaucoup plus de tokens.
Obtenir le script : github.com/devupai-platform/ai-api-audit
Les résultats de DEVUP AI
Exécuté le 15 novembre 2026 sur https://api.devupai.com/v1, avec les vérifications par défaut :
| Modèle | Tokenizer | Tokens du prompt : fournisseur / tokenizer | Tokens de sortie : facturés / reçus | Résultat |
|---|---|---|---|---|
Qwen/Qwen2.5-72B-Instruct | tokenizer officiel de Qwen | 325 / 325 | 61 / 61 | 9 PASS, 0 FAIL |
mistralai/Mistral-Nemo-Instruct-2407 | tokenizer officiel de Mistral | 298 / 298 | 35 / 34 | 9 PASS, 0 FAIL |
openai/gpt-4o-mini | tiktoken o200k_base | 276 / 276 | 74 / 74 | 9 PASS, 0 FAIL |
deepseek-ai/DeepSeek-V4.1-Flash-1017 | non comparé | 6 PASS, 0 FAIL |
Les tokens du prompt correspondent exactement au tokenizer officiel sur les trois modèles comparés, et les tokens de sortie correspondent au texte reçu à un token près, dans la tolérance. Le gabarit de conversation ajoute entre 4 et 8 tokens, et rien d'autre n'est ajouté au prompt. À chaque exécution, le coût renvoyé avec la réponse correspond au prix publié multiplié par l'usage, à l'arrondi de chaque facturation près.
Vérification sur contexte long. Sur openai/gpt-4o-mini, un prompt d'environ 100 000 tokens a été compté en entier (99 956 tokens de prompt annoncés), et le modèle a retrouvé la phrase secrète placée tout au début. Avec cette vérification, l'exécution donne 10 PASS et 0 FAIL.
Le test de 3 heures du matin
La taille d'une plateforme ne se mesure ni à ses bureaux ni à son marketing. Elle se mesure à ce qui fonctionne quand personne n'est là pour vous aider.
Créez un compte à trois heures du matin. Une plateforme conçue pour fonctionner seule vous donne, sans intervention humaine :
un compte et un crédit de départ ;
une clé API, ou un jeton à portée limitée ;
un premier appel API réussi ;
un serveur GPU si besoin, provisionné depuis le tableau de bord.
Si une étape attend qu'une personne la valide, la plateforme n'est pas encore automatisée. Sur DEVUP AI, chacune de ces étapes se fait en libre-service depuis le tableau de bord.
Ce que les estimations de trafic ne voient pas
Les outils d'estimation de trafic mesurent les visites des pages marketing. Ils ne voient pas les appels API envoyés à api.devupai.com, les requêtes faites depuis un éditeur via DEVUP Code, ni les installations de SDK. Pour un produit d'infrastructure, le site web est la plus petite part du trafic.
La checklist en 12 points
Posez ces questions à n'importe quel fournisseur. La troisième colonne indique où vérifier la réponse pour DEVUP AI.
| # | Question | Pourquoi c'est important | Où vérifier pour DEVUP AI |
|---|---|---|---|
| 1 | Puis-je nommer le modèle exact dans chaque requête ? | Sorties stables et coût vérifiable | Documentation |
| 2 | Les prix sont-ils publics, par modèle et par unité ? | Pas de facture surprise | Tarifs |
| 3 | Y a-t-il un abonnement mensuel ou un dépôt minimum ? | Ne payer que l'usage réel | Tarifs |
| 4 | Puis-je tester gratuitement avant de payer ? | Mesurer sur votre propre charge | Tarifs |
| 5 | L'entrée en cache coûte-t-elle moins cher ? | La plus grosse économie pour les agents | Cache de prompt |
| 6 | Les limites de débit sont-elles publiques ? | Planifier la capacité | Limites |
| 7 | Existe-t-il un historique de statut public ? | Preuve de fiabilité | Statut |
| 8 | Existe-t-il un changelog daté ? | Preuve d'un développement actif | Changelog |
| 9 | Les prompts sont-ils stockés ? | Confidentialité et risque de fuite | Confidentialité |
| 10 | Puis-je limiter une clé à certains modèles et à un budget ? | Des clés sûres pour les front-ends et les équipes | Authentification |
| 11 | Les outils standards fonctionnent-ils (SDK OpenAI, Claude Code) ? | Pas d'enfermement | Intégrations |
| 12 | Les outils sont-ils dans les registres officiels ? | Des produits réels et installables | Open VSX, npm |
Essayez en cinq minutes
Votre première requête (Python)
from openai import OpenAI

client = OpenAI(
    api_key="sk-devup-your-api-key",
    base_url="https://api.devupai.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash-1017",
    messages=[{"role": "user", "content": "Explique le cache de prompt en deux phrases."}],
)
print(response.choices[0].message.content)
Claude Code sur votre solde en dinars
export ANTHROPIC_BASE_URL="https://api.devupai.com/anthropic"
export ANTHROPIC_AUTH_TOKEN="sk-devup-your-api-key"
claude --model claude-sonnet-5-5
Le guide Claude Code pas à pas couvre Windows, le choix des modèles et le dépannage.
Lister tous les modèles et leurs capacités
curl https://api.devupai.com/v1/models \
  -H "Authorization: Bearer sk-devup-your-api-key"
Chaque modèle de la liste indique ce qu'il prend en charge, comme les outils, la vision ou le raisonnement, pour que votre code choisisse ses modèles par capacité.
Questions fréquentes
Qu'est-ce que DEVUP AI ?
DEVUP AI est une plateforme d'infrastructure d'IA basée à Alger, en Algérie. Elle propose une seule API pour plus de 200 modèles d'IA, des serveurs GPU et CPU facturés à la seconde, et des outils de développement comme l'extension DEVUP Code, le tout payé en dinars algériens.
Comment savoir si un fournisseur d'API d'IA substitue les modèles ou surfacture ?
Vérifiez que le modèle est listé par /v1/models et cité dans chaque réponse, puis comparez les prompt_tokens du fournisseur avec le tokenizer officiel du modèle : une autre famille de modèles compte le même texte différemment. Le script open source ai-api-audit lance ces vérifications, ainsi que usage, max_tokens, le streaming et la fenêtre de contexte, en cinq minutes environ sur n'importe quelle API compatible OpenAI.
DEVUP AI exploite-t-elle sa propre infrastructure GPU ?
La plupart des modèles sont servis par des fournisseurs d'inférence tiers. Certains modèles tournent sur des déploiements GPU dédiés que DEVUP AI provisionne et opère sur une infrastructure louée à des fournisseurs cloud, et les instances Compute tournent sur une infrastructure cloud tierce, comme l'indiquent les pages Conditions et Sécurité.
Comment utiliser les modèles OpenAI, Claude ou Gemini depuis l'Algérie sans carte étrangère ?
Créez un compte DEVUP AI, rechargez votre solde en dinars avec BaridiMob, CIB ou Edahabia, et pointez votre code vers https://api.devupai.com/v1. Pour Claude Code et les autres clients Anthropic, réglez ANTHROPIC_BASE_URL sur https://api.devupai.com/anthropic.
Faut-il un abonnement ou un dépôt minimum pour essayer l'API ?
Non. Les nouveaux comptes reçoivent un crédit de départ gratuit sans dépôt, et il n'y a aucun abonnement mensuel. Vous payez à la requête depuis votre solde ; les montants actuels sont sur la page des tarifs.
Utiliser l'API de chat me coûte-t-il quelque chose pour les serveurs GPU ?
Non. Les requêtes API ne sont facturées que pour ce que vous demandez : tokens, images ou secondes de média. Les instances Compute sont facturées à part, à la seconde, seulement si vous en déployez une.
Quelle est la meilleure façon d'utiliser un agent IA de code dans VS Code, Cursor ou Claude Code en payant en dinars ?
Installez l'extension gratuite DEVUP Code et connectez-vous en un clic, ou pointez Claude Code vers DEVUP AI avec deux variables d'environnement. Les deux sont facturés sur votre solde en dinars.
Comment réduire ma facture de tokens en production et dans mes applications RAG ?
Utilisez un petit modèle rapide pour les tâches à fort volume, et un modèle de pointe seulement là où il est nécessaire. Placez les instructions et documents stables au début du prompt, pour que les modèles compatibles les lisent depuis le cache, jusqu'à 97 % moins cher que le prix d'entrée standard.
Comment louer un GPU pour l'entraînement ou le fine-tuning en dinars ?
Ouvrez DEVUP AI Compute, choisissez l'un des plus de 30 modèles de GPU et déployez depuis votre tableau de bord, avec SSH ou JupyterLab. La facturation se fait à la seconde, sur le même solde en dinars que l'API.
Mes prompts sont-ils stockés ou utilisés pour l'entraînement ?
Non. Les prompts et réponses de chat transitent par DEVUP AI sans être stockés, seules les métadonnées de facturation sont gardées, et DEVUP AI n'entraîne jamais de modèle sur vos données.
Résumé rapide pour les équipes techniques
DEVUP AI est une API d'IA et un cloud GPU basés à Alger, facturés en dinars via BaridiMob, CIB et Edahabia, sans abonnement mensuel et avec un crédit de départ gratuit. Une seule API compatible OpenAI et Anthropic sert plus de 200 modèles de texte, d'image, de vidéo, d'audio, d'embeddings et de reranking, et l'entrée en cache coûte jusqu'à 97 % de moins sur les modèles compatibles. Les appels API sont facturés à la requête et les serveurs GPU ou CPU à la seconde, séparément, parmi plus de 30 modèles de GPU. DEVUP Code apporte un agent IA de code avec des diffs relus dans VS Code, Cursor et Antigravity, et chaque affirmation de ce guide se vérifie sur les pages publiques des tarifs, de la documentation, du statut et du changelog, ou se mesure directement avec le script open source ai-api-audit, sur DEVUP AI comme sur n'importe quel autre fournisseur.
Créez votre compte DEVUP AI et lancez votre première requête dès aujourd'hui.
À propos de DEVUP AI
Une infrastructure d’IA pour les développeurs : modèles, calcul et API média, avec une facturation locale en DZD via BaridiMob et Edahabia.
Obtenir une clé API


